一条 SQL 被一个懵懂的少年,一阵蹂躏,扔向了 MySQL 服务器的尽头,少年苦苦等待,却迟迟等不来那满载而归的硕果。于是少年气愤,费尽苦心想从度娘那边寻求帮助,面对执行计划 EXPLAIN,却等来的是无尽的折磨与抓狂。
通过 explain 命令,根据执行计划找到存在性能问题的 SQL 语句,以帮助我们优化 SQL 提供方向和依据。
如果面对执行计划,你也是一脸疑惑,甚至抓狂,那么你真的需要认真的来了解它了。在数据库性能优化中,执行计划,真的很重要,通过执行计划能够帮助我们更加明确的来进行 SQL 优化。本文将从执行计划开始说起,讲解执行计划该如何用,其中各个列的含义究竟是什么。
一、执行计划?
执行计划,就是一条 SQL 语句,在数据库中实际执行的时候,一步步的分别都做了什么。也就是我们用 EXPLAIN 分析一条 SQL 语句时展示出来的那些信息。
EXPLAIN 命令是查看查询优化器是如何决定执行查询的主要方法,从它的查询结果中可以知道一个 SQL 语句每一步是如何执行的,都经历了些什么,分为哪几步,有没有用到索引,哪些字段用到了什么样的索引,是否有一些可优化的地方等,这些信息都是我们SQL优化的依据。
要使用 EXPLAIN,只需在查询中的 SELECT 关键字之前增加 EXPLAIN。语法如下:
EXPLAIN + SELECT 查询语句;
当执行执行计划时,只会返回执行计划中每一步的信息,它会返回一行或多行信息,显示出执行计划中的每一部分和执行的次序。
如:
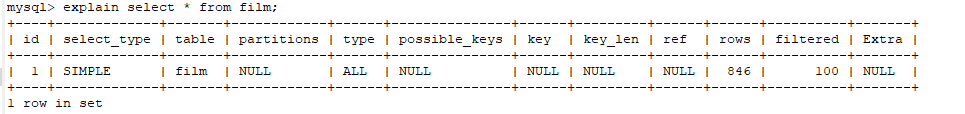
如果查询的是多个关联表,执行计划结果可能是多行。
在接下来涉及到的示例表,均来自于MySQL官方的示例数据库
sakila,脚本下载:https://downloads.mysql.com/docs/sakila-db.zip
二、执行计划中的列
EXPLAIN 的结果总是有相同的列,每一列代表着不同的含义,可变的只是行数和内容。从上面的例子中,我们看到返回的有很多列,为了更加清楚的了解每一列的含义,便于我们更好的完成优化 SQL。
涉及到的列有:
| 列名 | 含义 |
|---|---|
| id | id 列,表示查询中执行 select 子句或操作表的顺序。 |
| select_type | 查询类型,主要是用于区分普通查询、联合查询、子查询等复杂的查询。 |
| table | 表明对应行正在访问的是哪个表。 |
| partitions | 查询涉及到的分区。 |
| type | 访问类型,决定如何查找表中的行。 |
| possible_keys | 查询可以使用哪些索引。 |
| key | 实际使用的索引,如果为NULL,则没有使用索引。 |
| key_len | 索引中使用的字节数,查询中使用的索引的长度(最大可能长度),并非实际使用长度,理论上长度越短越好。 |
| ref | 显示索引的那一列被使用。 |
| rows | 估算出找到所需行而要读取的行数。 |
| filtered | 返回结果的行数占读取行数的百分比,值越大越好。 |
| Extra | 额外信息,但又十分重要。 |
1. id 列
id 列是一个编号,用于标识 SELECT 查询的序列号,表示执行 SQL 查询过程中 SELECT 子句或操作表的顺序。
如果在 SQL 中没有子查询或关联查询,那么 id 列都将显示一个 1。否则,内层的 SELECT 语句一般会顺序编号。
id 列分为三种情况:
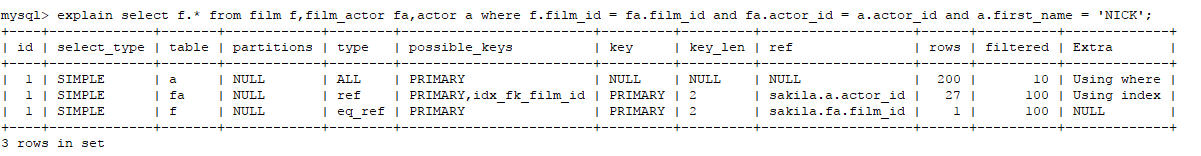
1)id 相同
如下普通查询,没有子查询。
explain select f.* from film f,film_actor fa,actor a where f.film_id = fa.film_id and fa.actor_id = a.actor_id and a.first_name = 'NICK';
2)id 不同
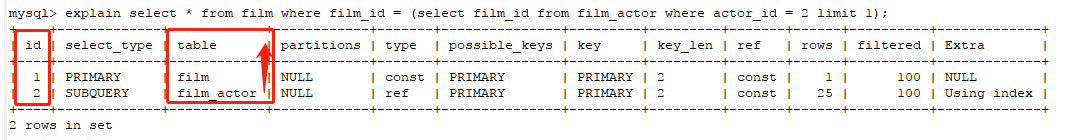
如果存在子查询,id 的序号会递增,id 值越大优先级越高,越先被执行。
explain select * from film where film_id = (select film_id from film_actor where actor_id = 2 limit 1);
3)id 相同又不同
1)、2)两种情况同时存在。id 如果相同,认为是一组,从从上往下执行。在所有组中,id 值越大,优先级越高,越先执行。
2. select_type 列
select_type 列表示对应行的查询类型,是简单查询还是复杂查询,主要用于区分普通查询、联合查询、子查询等复杂的查询。
select_type 列有如下值:
| select_type值 | 说明 |
|---|---|
| SIMPLE | 简单查询,意味着不包括子查询或 UNION。 |
| PRIMARY | 查询中包含任何复杂的子部分,最外层查询则被标记为 PRIMARY |
| SUBQUERY | 在 select 或 where 列表中包含了子查询 |
| DERIVED | 表示包含在 from 子句的子查询中的 select,MySQL 会递归执行并将结果放到一个临时表中,称其为“派生表”,因为该临时表是从子查询中派生而来的。 |
| UNION | 第二个 select 出现在 UNION 之后,则被标记为 UNION。 |
| UNION RESULT | 从 UNION 表获取结果的 select。 |
3. table 列
table 列表示对应行正在执行的哪张表,指代对应表名,或者该表的别名(如果 SQL 中定义了别名)。
4. partitions 列
查询涉及到的分区。
5. type 列
type 列指代访问类型,是 MySQL 决定如何查找表中的行。
是 SQL 查询优化中一个很重要的指标,拥有很多值,依次从最差到最优:
ALL < index < range < index_subquery < unique_subquery < index_merge < ref_or_null < fulltext < ref < eq_ref < const < system
1)ALL
众所周知的全表扫描,表示通过扫描整张表来找到匹配的行,很显然这样的方式查询速度很慢。
这种情况,性能最差,在写SQL时尽量避免此种情况的出现。
举例如下:
explain select * from film;
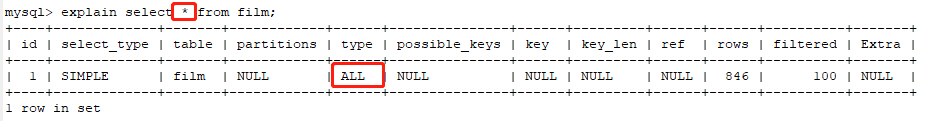
在平时写 SQL 时,避免使用 select *,就不难理解了。换言之,是为了避免全表扫描,因为全面扫描是性能最差的。
2)index
全索引扫描,和全表扫描 ALL 类似,扫描表时按索引次序进行,而不是按行扫描,即:只遍历索引树。
index 与 ALL 虽然都是读全表,但 index 是从索引中读取,而 ALL 是从硬盘读取。显然,index 性能上优于 ALL,合理的添加索引将有助于性能的提升。
举例如下:
explain select title from film;
explain select description from film;
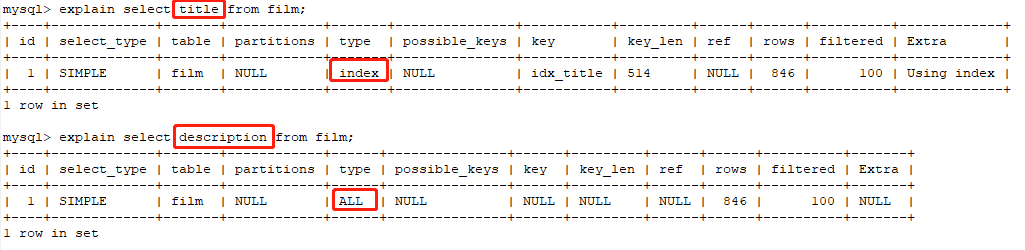
通过 explain 结果来看,只查询表 film 中字段 title 时,是按照索引扫描的(type 列为 index),倘若查询字段 description,却是按照全表扫描的(type 列为 ALL)。这是为何呢?
接下来,我们不妨看看表 film 的结构:
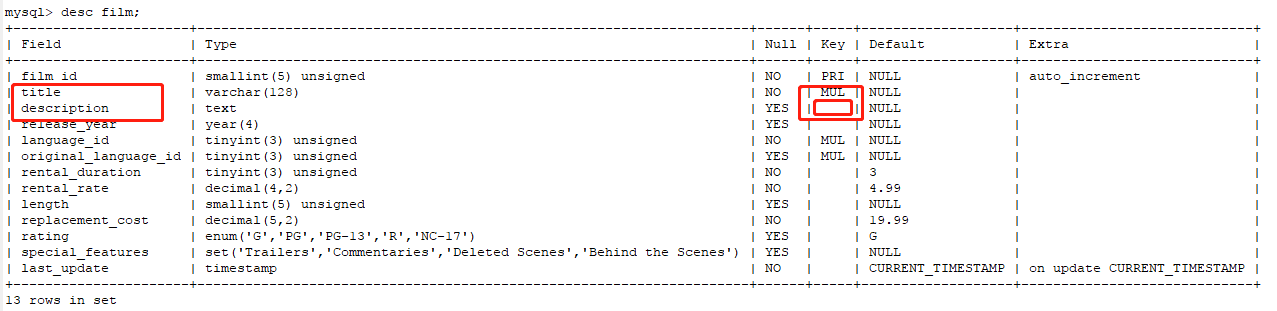
从 desc film 结果来看,字段 title 创建的有索引,而字段 description 没有,所以 select title from film 是按索引扫描,而 select description from film 按全表扫描。
从上面的举例对比中,也充分印证了索引的重要性。
3)range
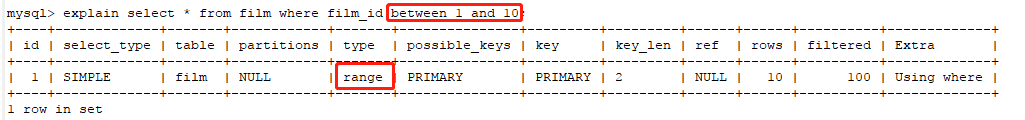
只检索给定范围的行,使用一个索引来选择行。key 列显示使用了那个索引。一般就是在 where 语句中出现了 bettween、<、>、in 等的查询。这种索引列上的范围扫描比全索引扫描 index 要好。
举例如下:
explain select * from film where film_id between 1 and 10;
4)ref
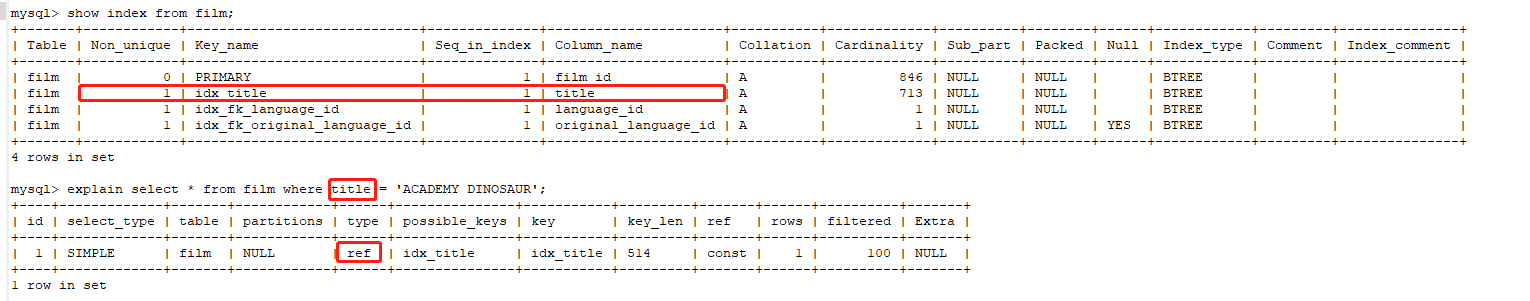
非唯一性索引扫描,返回匹配某个单独值的所有行。本质是也是一种索引访问,它返回所有匹配某个单独值的行,然而它可能会找到多个符合条件的行,所以它属于查找和扫描的混合体。
此类型只有当使用非唯一索引或者唯一索引的非唯一性前缀时,才会发生。
举例如下:
show index from film;
explain select * from film where title = 'ACADEMY DINOSAUR';
5)eq_ref
**唯一索引扫描。**常见于主键或唯一索引扫描。
6)const
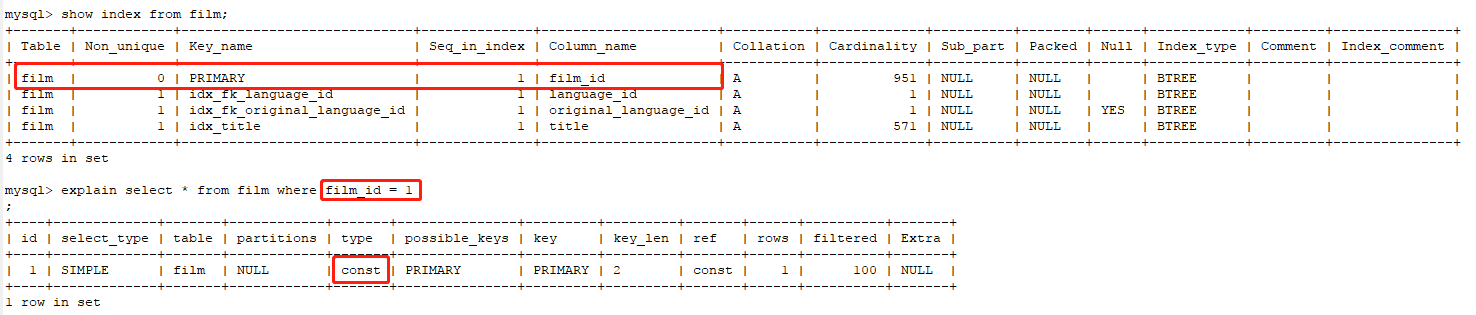
通过索引一次就能找到,const 用于比较 primary key 或者 unique 索引。因为只需匹配一行数据,所有很快。如果将主键置于 where 列表中,MySQL 就能将该查询转换为一个 const。
举例如下:
show index from film;
explain select * from film where film_id = 1;
7)system
表只有一行记录,这是 const 类型的特例,比较少见,如:系统表。
6. possible_keys 列
显示在查询中使用了哪些索引。
7. key 列
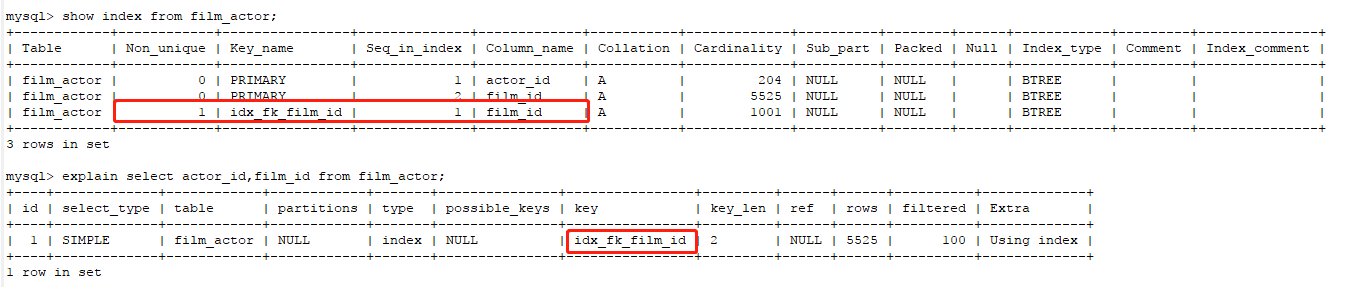
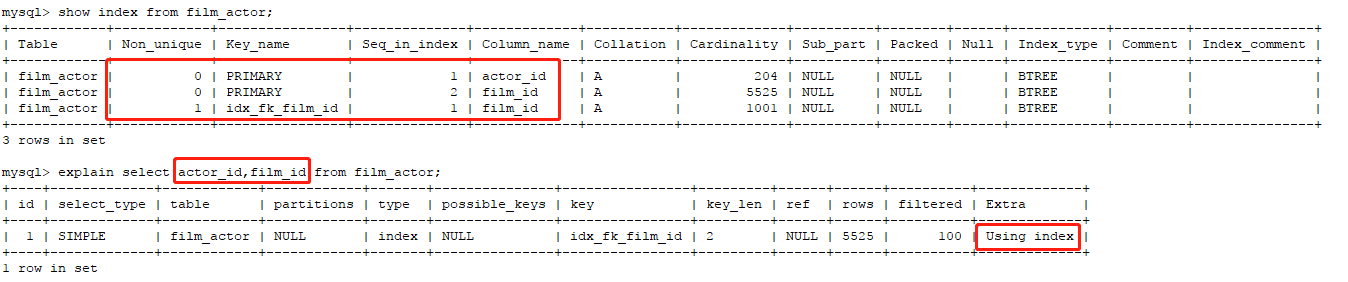
实际使用的索引,如果为 NULL,则没有使用索引。查询中如果使用了覆盖索引,则该索引仅出现在 key 列中。
possible_keys 列表明哪一个索引有助于更高效的查询,而 key 列表明实际优化采用了哪一个索引可以更加高效。
举例如下:
show index from film_actor;
explain select actor_id,film_id from film_actor;
8. key_len 列
表示索引中使用的字节数,查询中使用的索的长度(最大可能长度),并非实际使用长度,理论上长度越短越好。key_len 是根据表定义计算而得的,不是通过表内检索出的。
9. ref 列
表示在 key 列记录的索引中查找值,所用的列或常量 const。
10. rows 列
估算出找到所需行而要读取的行数。
这个数字是内嵌循环关联计划里的循环数,它并不是最终从表中读取出来的行数,而是 MySQL 为了找到符合查询的那些行而必须读取行的平均数,只能作为一个相对数来进行衡量。
11. filtered 列
返回结果的行数占读取行数的百分比,值越大越好。
举例如下:
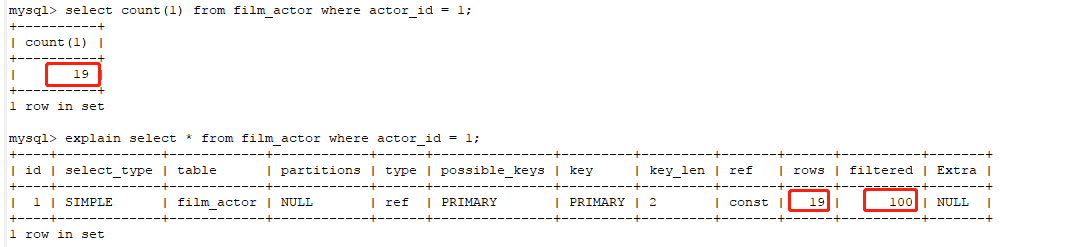
表 film_actor中actor_id 为 1 的记录有 19 条,而 SQL 查询时扫描了 19 行(rows:19),19 条符合条件(filtered: 100 19/19)
12. Extra 列
额外信息,但又十分重要。
常见的值如下:
1)Using index
表示 SQL 中使用了覆盖索引。
举例如下:
2)Using where
许多 where 条件里是涉及索引中的列,当它读取索引时,就能被存储引擎检验,因此不是所有带 where 子句的查询都会显示 Using where。
3)Using temporary
对查询结果排序时,使用了一个临时表,常见于 order by 和 group by。
4)Using filesort
对数据使用了一个外部的索引排序,而不是按照表内的索引进行排序读取。也就是说 MySQL 无法利用索引完成的排序操作成为“文件排序”。
三、总结
通过上述对执行计划的了解,我们能够从中得到什么?
- SQL 如何使用索引
- 复杂 SQL 的执行顺序
- 查询扫描的数据函数
- ……
当面临不够优的 SQL 时,我们首先要查看其执行计划,根据执行计划结果来分析可能存在哪些问题,从而帮助、指导我们是否添加索引、是否调整 SQL 顺序、是否避免不应该的书写方式等等。
以上就是这篇文章的全部内容,希望本文的内容对大家在SQL性能优化、SQL 书写时,有一定的帮助。
执行计划,真的很重要,尤其是 SQL 调优时,很香!